
AI Code Review 为什么需要真实编译配置?
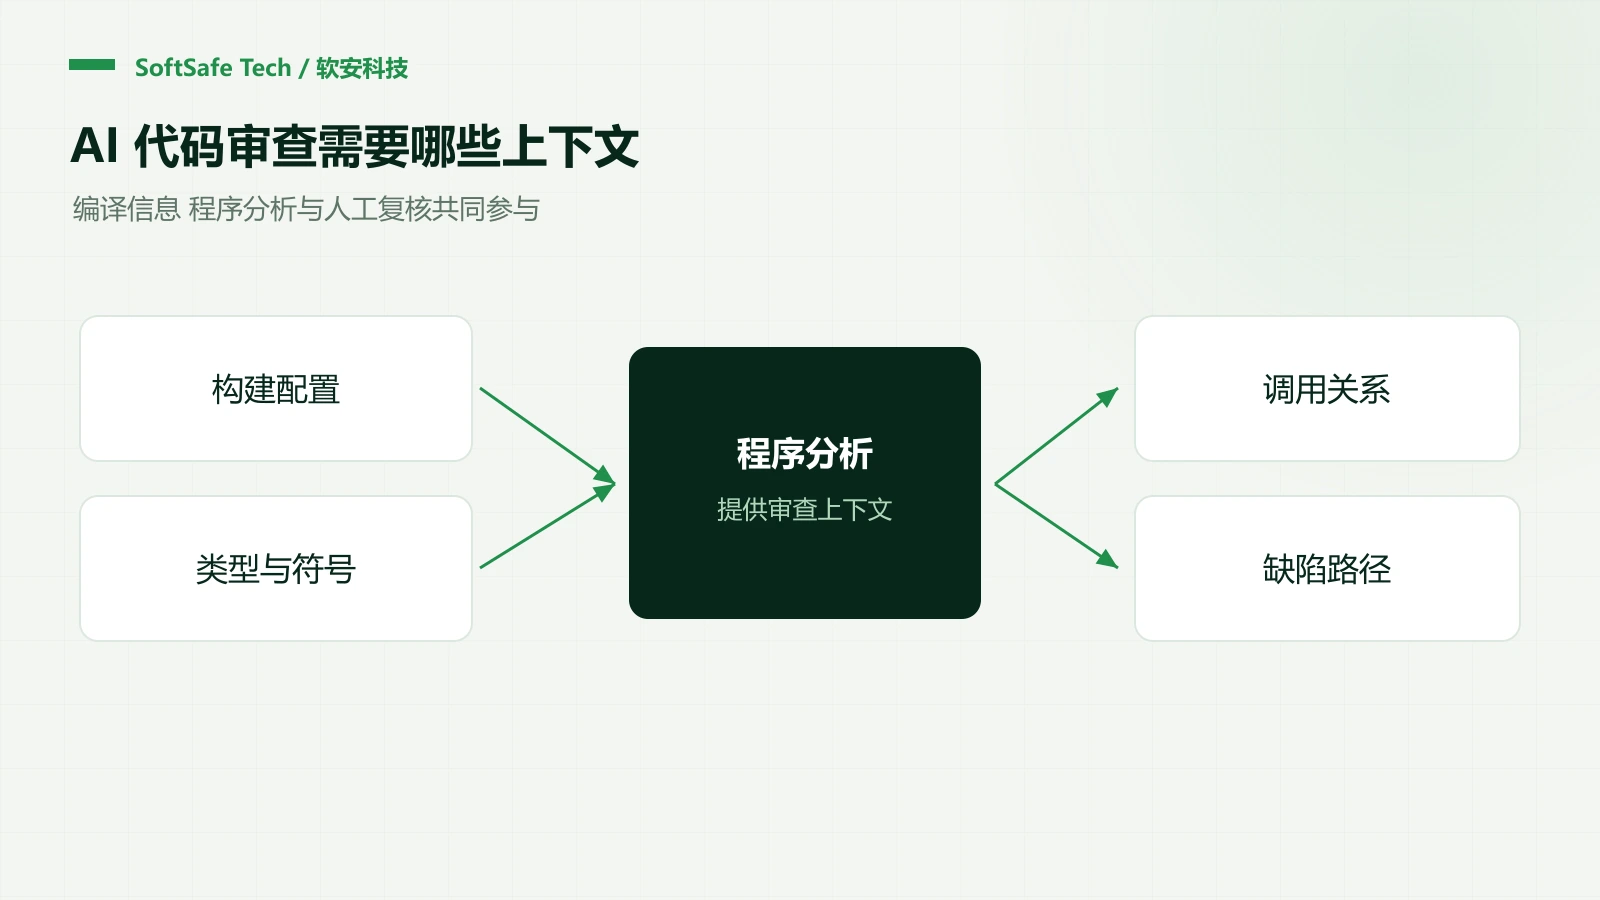
真实编译配置能帮助 AI Code Review 判断“这次构建实际包含哪些代码”,并为类型、调用关系和数据传播提供上下文。对大量使用宏、交叉编译和厂商扩展的 C/C++ 工程,这些信息直接影响告警是否成立。
同一份源码可能对应不同程序
条件编译会让同一文件在不同产品配置下启用不同实现。头文件搜索路径、目标平台和编译器选项也可能改变类型解释。只看到源码片段,审查者可能把互斥分支同时当作有效逻辑,或漏掉实际参与构建的实现。
Clang 的编译数据库用工作目录、源文件及实际编译命令描述翻译单元,并允许同一文件对应不同配置。因此,接入分析前应确认数据库来自待交付的目标构建,且生成文件、头文件与工具链信息可用。Clang 编译数据库规范
编译信息如何帮助形成缺陷证据
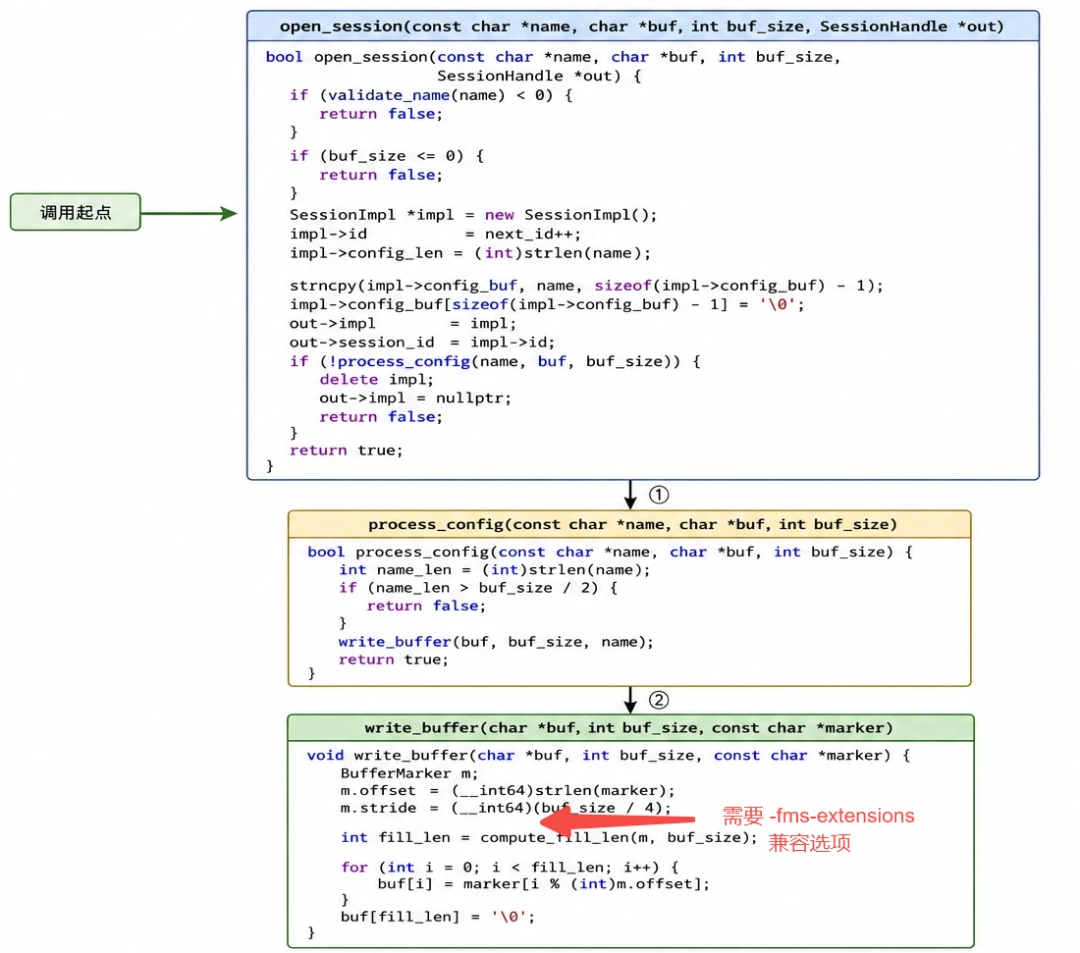
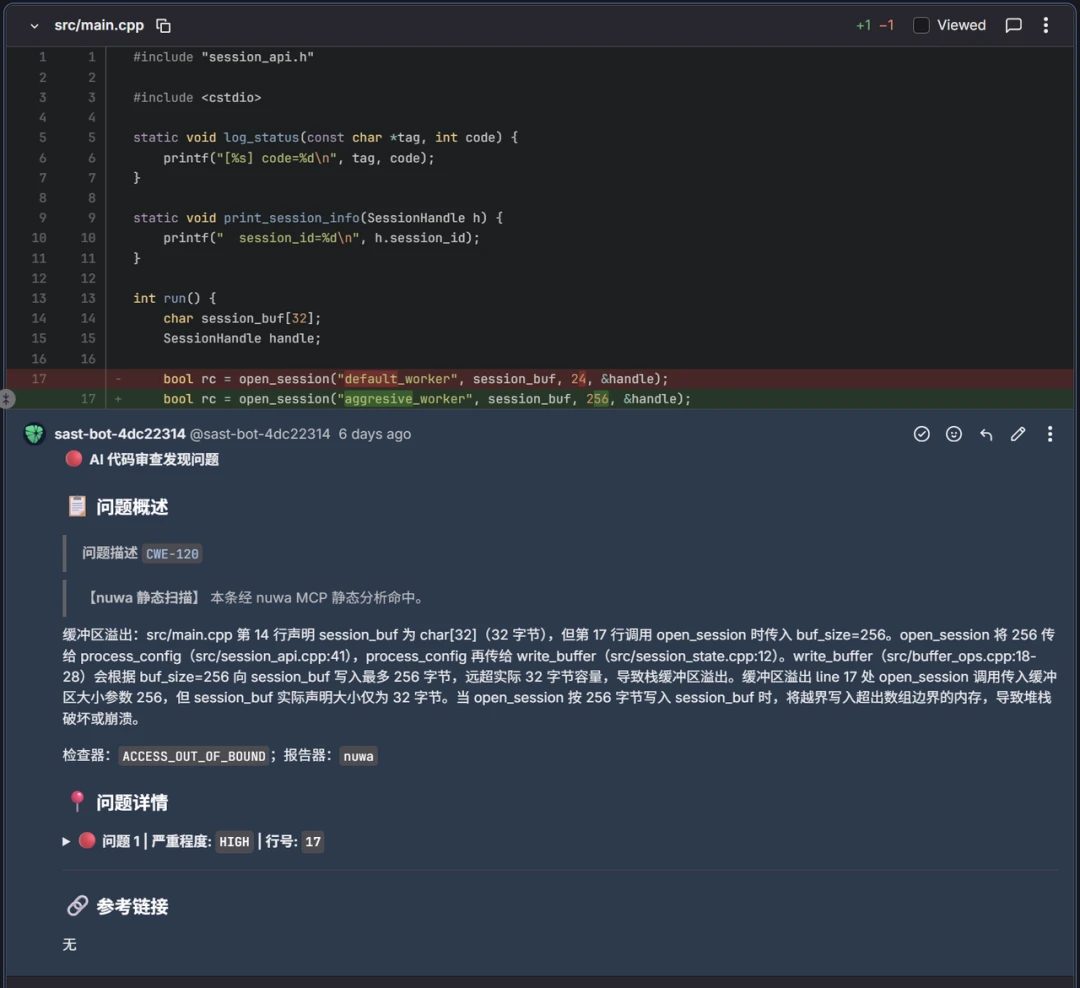
以一个教学场景为例:调用者分配 32 字节缓冲区,却把容量参数写成 256。该参数经多个函数传给写入函数。只有确认下游实际写入可能超过 32 字节,且这条路径可达,才能形成越界判断;错误容量是线索,本身并不等于已发生越界。
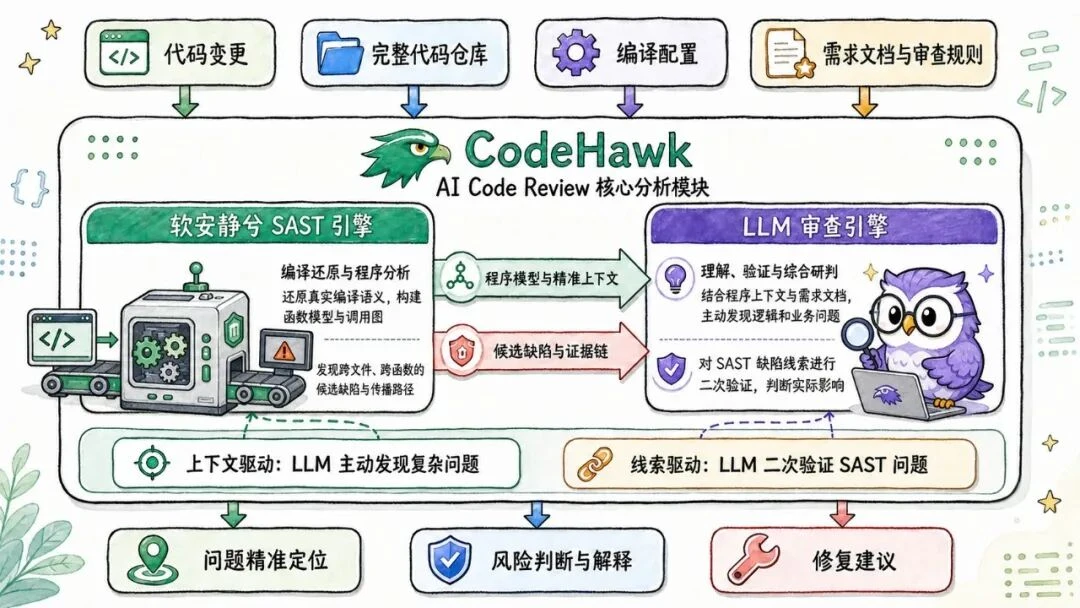
较好的审查结果应展示有效宏配置、参数传播、实际边界、触发条件和相关代码。静态分析可以为大模型提供这些结构化线索,大模型则辅助解释影响、核对需求和提出修复建议。
评估工具时检查什么
选择一个有代表性的工程,先检查解析覆盖范围:哪些文件成功进入模型,哪些函数缺少实现,哪些扩展语法被转换或跳过。再抽查告警:每一步能否回到源代码,条件能否由配置和数据支持,修复后能否用测试验证。
对于厂商私有语法,不能只以“扫描能继续运行”判断适配成功。如果规整过程丢失类型、边界或副作用信息,后续推理仍可能偏离实际程序。
能力边界与产品实践
构建信息提高的是上下文可靠性,不能证明程序没有缺陷。外部库模型、并发行为、运行输入和业务约束仍可能不完整;未报告问题也可能源于分析范围不足。
CodeHawk 采用“LLM + SAST”协同架构,由静兮提供程序模型与候选缺陷线索,再由大模型参与审查。具体编译器支持、分析范围和版本能力,应在实际工程验证中确认。
有编译数据库就不需要人工审查了吗? 仍需要。它解决构建上下文问题,无法替代需求判断和风险决策。
如何对待 AI 给出的修复代码? 将其作为候选修改,检查所有权、边界和兼容性,再运行能够覆盖缺陷触发路径的回归测试。