
AI 软件供应链安全怎么做?从资产清单到智能体权限治理
治理 AI 软件供应链,第一步是把代码依赖、模型、数据、框架、工具和智能体接口放进同一张资产视图;随后把这些资产连接到准入、权限、测试、变更和事件响应流程。只有清单而没有运行控制,仍然无法回答智能体能够调用什么、数据会流向哪里以及变更后是否需要重新验证。
AI 治理最终要落到工程对象
2026 世界人工智能大会暨人工智能全球治理高级别会议把安全、可靠、可控作为人工智能治理的重要议题。对研发团队而言,这些目标需要转化成可以记录和验证的工程问题:模型来自哪里,训练或微调数据怎样管理,使用了哪些框架和外部服务,智能体具有什么权限,出现异常后能否追溯到具体版本。
供应链边界已经超出代码和组件
传统 SBOM 主要记录软件包、版本、依赖关系和许可证。AI 系统继续使用这些软件资产,但还会引入模型权重、数据集、训练与推理框架、提示词模板、向量库、插件、Skills、MCP 服务、外部 API 和智能体工具。任何一个对象发生替换,都可能改变系统的安全边界。
例如,同一个业务智能体即使应用代码没有变化,替换模型版本也可能改变指令遵循方式;增加一个检索数据源可能引入新的敏感信息;接入一个 MCP 服务则可能扩大可执行动作。传统依赖清单看不到这些变化之间的关系,因此组织需要把软件供应链记录扩展成 AI 系统资产与调用关系图。
- 代码与开源依赖:组件名称、版本、来源、许可证和已知漏洞
- 模型与权重:提供方、版本、获取位置、校验信息和允许用途
- 数据资产:来源、处理方式、使用范围和敏感性标记
- 框架与运行环境:训练、推理、编排及部署所使用的软件栈
- 工具与接口:插件、Skills、MCP 服务、外部 API 及其调用权限
- 变更记录:谁在何时替换了哪个对象,经过了哪些复核和测试
需要关注的三类新风险
模型投毒
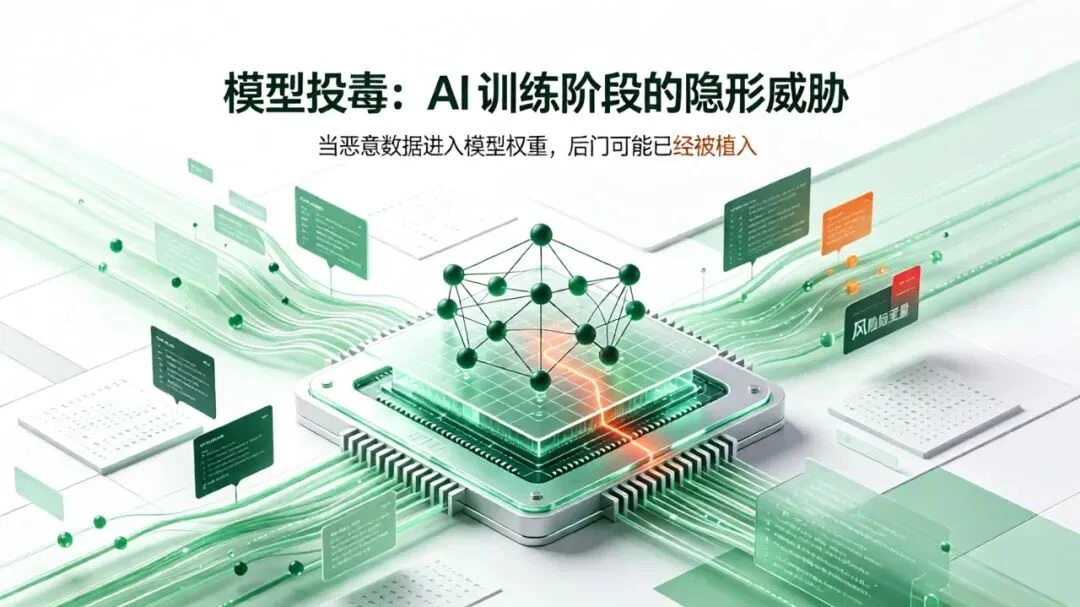
风险可能在训练数据、微调过程或模型权重中被引入,并在特定输入条件下表现为异常输出。检查时不能只记录模型名称,还需要保留版本、来源、完整性校验、训练或微调说明以及验证结果。
复核模型风险时,可以先确认模型文件与发布方记录是否一致,再检查组织是否进行过二次训练或量化处理,并用覆盖正常任务、边界输入和对抗输入的测试集记录行为差异。如果模型由外部 API 提供,还要记录服务版本、区域、数据保留策略和供应商变更通知机制。
工具投毒与依赖污染
训练框架、数据处理工具、推理引擎、插件和第三方包都可能成为传播路径。组织需要确认下载来源、锁定版本、验证完整性,并记录镜像、构建环境和部署产物之间的对应关系。只扫描业务代码,无法覆盖这些上游对象。
这类检查既包括常规组件漏洞与许可证,也包括模型加载过程中执行远程代码、插件自动安装依赖、容器镜像夹带未知工具等 AI 工程场景。团队应保存锁定文件、制品摘要、构建日志和部署清单,使发现的问题能够定位到具体环境。
智能体目标劫持与过度授权
智能体会接收自然语言内容并调用外部工具。恶意或未经验证的上下文可能改变其行为,如果工具权限过大,错误决策就可能进一步变成数据读取、文件修改或外部操作。OWASP 将 Excessive Agency 列为生成式 AI 应用需要控制的风险之一,重点包括功能、权限和自主程度是否超过任务所需。OWASP Excessive Agency
因此,智能体评估不能停留在回答内容是否正确。还要沿着“输入内容—模型判断—工具选择—参数生成—实际执行—结果回传”检查完整链路,确认非可信内容不能绕过授权规则,并验证执行失败或返回异常时系统是否安全停止。
先建立可更新的 AI 资产清单
AI-BOM 可以把模型、数据集、软件包和工具等对象放入统一记录,并描述它们之间的关系。SPDX 3 提供了面向 AI 对象的模型,可以作为交换和组织相关信息的参考。SPDX AI Profile
- 为每类资产建立稳定标识,记录名称、版本、来源和责任人
- 把模型与数据、框架、插件和运行环境之间的关系连接起来
- 保存许可证、使用限制、完整性校验和风险判断依据
- 让资产记录能够对应具体产品版本、部署环境和发布日期
- 在依赖、模型或权限变化后触发复核,而不是只做一次性盘点
把清单接入准入和变更流程
清单只有进入实际流程才会产生治理价值。新模型、数据集或工具进入项目时,应先完成来源、许可证、完整性和用途检查;通过准入后再配置权限和测试范围。资产被替换、升级或重新训练时,系统需要识别差异并决定哪些安全结论必须重新验证。
每一次判断都应能够回答四个问题:检查的是哪个版本,使用了什么规则或测试集,谁作出了处置决定,结果对应哪个发布版本。这样,AI-BOM 才能从静态清单变成连接研发、测试、发布和审计的证据索引。
再控制智能体的工具与权限
资产可见之后,还要限制智能体可以执行的动作。工具注册、身份认证、访问范围、参数校验、人工确认和运行日志需要形成连续控制。高风险操作应采用最小权限,并根据数据敏感度和业务后果设置人工复核。
- 功能边界:只向智能体开放完成任务所需的工具
- 数据边界:限制可读取、写入和传出的数据范围
- 执行边界:对删除、发布、支付和权限变更等操作增加确认
- 网络边界:限定外部服务、域名和接口调用范围
- 审计边界:记录输入、模型版本、工具调用、返回结果和最终动作
把验证放进变更流程
AI 系统的风险结论会随模型、提示词、数据、工具和权限变化。有效做法是把安全验证接入开发与发布流程,在每次重要变更后重新检查资产差异、权限影响和关键任务表现,并保留可复现的测试输入与结果。
- 比较新旧版本的模型、依赖、数据和工具清单
- 识别新增权限、外部连接和高影响操作
- 执行提示词注入、异常上下文和工具滥用等安全测试
- 复核失败路径是否会导致越权、敏感数据泄露或不可逆操作
- 将发现、处置、例外批准和复测结果关联到发布版本
上线后的监测同样需要引用这些资产关系。当出现异常工具调用、越权尝试或模型行为漂移时,团队应能够迅速确定受影响的模型、智能体、部署环境和用户范围,并回溯最近的依赖、提示词与权限变化。没有版本化资产记录,事件响应只能依靠人工逐项排查。
AgentST 在治理流程中的定位
在上述治理框架中,AgentST 面向模型、数据集、框架、智能体 Skills、工具和 MCP 接口等 AI 资产开展识别与关系梳理,并辅助团队检查依赖和调用链中的安全问题。工具输出需要与组织的准入规则、权限管理、测试记录和人工判断结合,才能形成可用于发布与审计的证据。
AI 软件供应链安全不是在传统组件扫描之外增加一张模型清单。它要求组织同时管理资产来源、运行权限和持续验证:知道系统由什么组成,理解每个对象能够影响什么,并在每次变化后重新证明关键边界仍然有效。